 مشاوره طراحی اپ
مشاوره طراحی وب اپ
 مشاوره طراحی سایت
 مشاوره سئوی سایت
 مشاوره تبلیغات گوگل
 مشاوره اینستاگرام
اشتراک گذاری این مطلب


چگونه دیتابیس مناسب اپلیکیشن را انتخاب کنیم؟ مقایسه PostgreSQL، MySQL،MongoDB

 ۱۴۰۵/۰۸/۱۸
- دیتابیس چیست و چه نقشی در عملکرد و معماری اپلیکیشن دارد؟
- انتخاب دیتابیس چه تأثیری بر اپلیکیشن و کسب و کار دارد؟
- چه عواملی در انتخاب دیتابیس مناسب اپلیکیشن مؤثر هستند؟
- مقایسه دیتابیس های SQL و NoSQL؛ کدام مدل برای اپلیکیشن شما مناسب تر است؟
- محبوب ترین و پرکاربردترین دیتابیس ها در توسعه اپلیکیشن
- مقایسه جامع PostgreSQL MySQL و MongoDB؛ بررسی تفاوت ها عملکرد و معیارهای انتخاب
- مراحل انتخاب دیتابیس مناسب اپلیکیشن
- نتیجه گیری؛ راهنمای انتخاب دیتابیس مناسب اپلیکیشن
- توسعه اپلیکیشن اختصاصی با کیان تجارت شریف
- سوالات متداول درباره انتخاب دیتابیس مناسب اپلیکیشن
انتخاب دیتابیس مناسب اپلیکیشن نقش مهمی در عملکرد، پایداری و قابلیت توسعه آن دارد. نوع و حجم داده ها، الگوهای دسترسی، الزامات تراکنشی، ساختار اپلیکیشن و نیازهای آینده پروژه، همگی بر این انتخاب تأثیر می گذارند؛ بنابراین، نمی توان یک دیتابیس را برای همه پروژه ها بهترین گزینه دانست.
در این مقاله، معیارهای اصلی انتخاب دیتابیس را بررسی می کنیم و با پرداختن به مقایسه SQL وNoSQL و بررسی تفاوت PostgreSQL و MySQL در کنار آشنایی با ویژگی های MongoDB، به شما کمک می کنیم متناسب با نیازهای اپلیکیشن خود انتخاب دقیق تری داشته باشید.
دیتابیس چیست و چه نقشی در عملکرد و معماری اپلیکیشن دارد؟
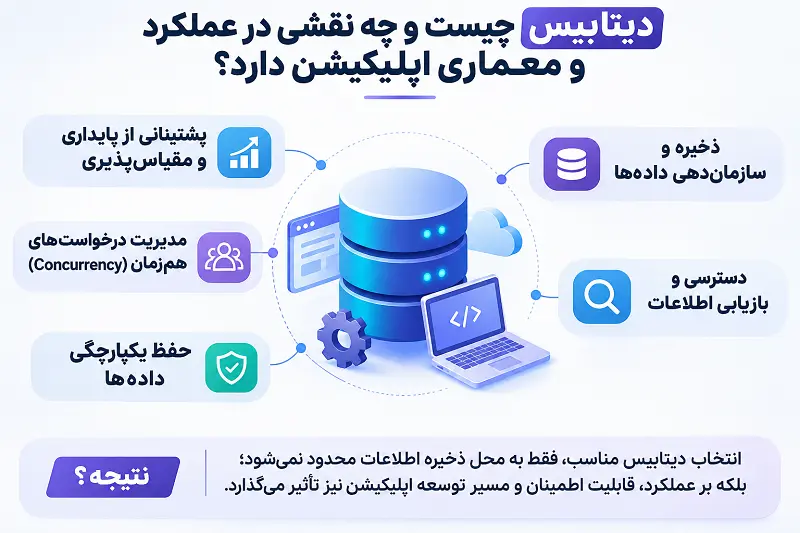
دیتابیس (Database) یا پایگاه داده، مجموعه ای سازمان یافته از اطلاعات است که امکان ذخیره سازی، جست وجو، بازیابی و به روزرسانی داده ها را فراهم می کند. در اپلیکیشن ها، اطلاعاتی مانند مشخصات کاربران، محصولات، سفارش ها و تراکنش ها در دیتابیس نگهداری می شوند تا بخش های مختلف سیستم بتوانند بر اساس نیاز به آن ها دسترسی داشته باشند.
دیتابیس صرفاً محلی برای ذخیره اطلاعات نیست، بلکه یکی از اجزای اصلی معماری بک اند اپلیکیشن محسوب می شود. نحوه سازمان دهی داده ها و مدیریت درخواست ها در پایگاه داده می تواند بر سرعت پاسخ گویی، یکپارچگی اطلاعات و توانایی سیستم برای مدیریت بار کاری تأثیر بگذارد. مهم ترین نقش های دیتابیس در یک سیستم نرم افزاری عبارت اند از:
- ذخیره و سازمان دهی داده ها: اطلاعات کاربران، محصولات، سفارش ها و سایر داده های سیستم بر اساس مدل و ساختار پایگاه داده نگهداری می شوند تا مدیریت و دسترسی به آن ها امکان پذیر باشد.
- دسترسی و بازیابی اطلاعات: اپلیکیشن می تواند داده های موردنیاز را جست وجو و بازیابی کند یا در صورت نیاز آن ها را به روزرسانی کند. طراحی مناسب Queryها و ایندکس ها نیز می تواند به بهبود سرعت دسترسی به اطلاعات کمک کند.
- حفظ یکپارچگی داده ها: قواعد و محدودیت های پایگاه داده، مانند کلیدهای اصلی، کلیدهای خارجی و محدودیت های یکتایی، به جلوگیری از ثبت داده های نامعتبر یا ناسازگار کمک می کنند.
- مدیریت درخواست های هم زمان (Concurrency): پایگاه داده امکان مدیریت دسترسی هم زمان کاربران و سرویس های مختلف به داده ها را فراهم می کند و با سازوکارهای کنترلی خود به جلوگیری از تداخل میان عملیات کمک می کند.
- پشتیبانی از پایداری و مقیاس پذیری: انتخاب و طراحی مناسب دیتابیس، در کنار سایر اجزای معماری، می تواند به سیستم کمک کند با افزایش حجم داده ها و تعداد درخواست ها سازگار شود. البته میزان دسترس پذیری و تاب آوری سیستم به عواملی مانند Replication، پشتیبان گیری، بازیابی اطلاعات و معماری کلی زیرساخت نیز وابسته است.
این وظایف نشان می دهند که انتخاب دیتابیس مناسب فقط به محل ذخیره اطلاعات محدود نمی شود؛ بلکه با عملکرد، قابلیت اطمینان و مسیر توسعه اپلیکیشن نیز ارتباط دارد. به همین دلیل، هنگام انتخاب پایگاه داده باید علاوه بر نوع و حجم داده ها، الگوی دسترسی، الزامات تراکنشی و نیازهای آینده سیستم را نیز در نظر گرفت.
انتخاب دیتابیس چه تأثیری بر اپلیکیشن و کسب و کار دارد؟
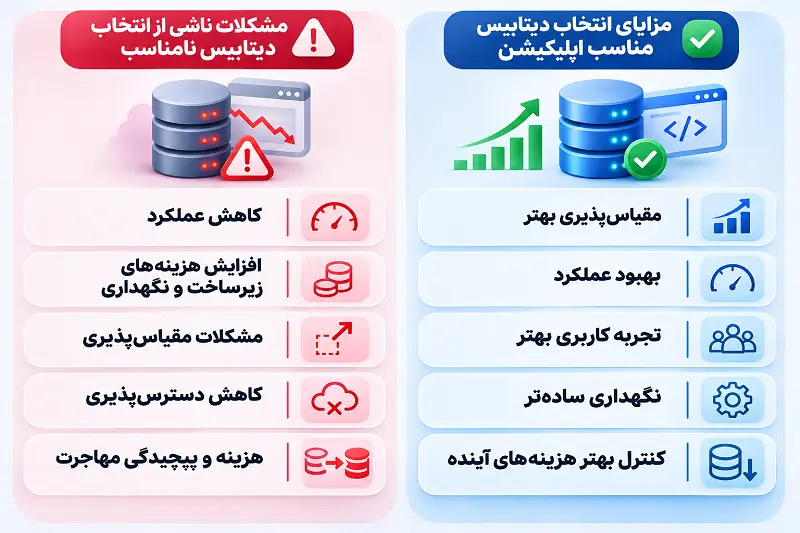
دیتابیسی که با نیازهای پروژه تناسب داشته باشد، می تواند مسیر توسعه و نگهداری اپلیکیشن را ساده تر کند و در مقابل، انتخاب نامناسب ممکن است با افزایش کاربران و حجم داده، محدودیت های خود را نشان دهد. این تصمیم می تواند روی عملکرد، مقیاس پذیری، هزینه های نگهداری و پایداری اپلیکیشن تأثیر بگذارد.
مزایای انتخاب دیتابیس مناسب اپلیکیشن
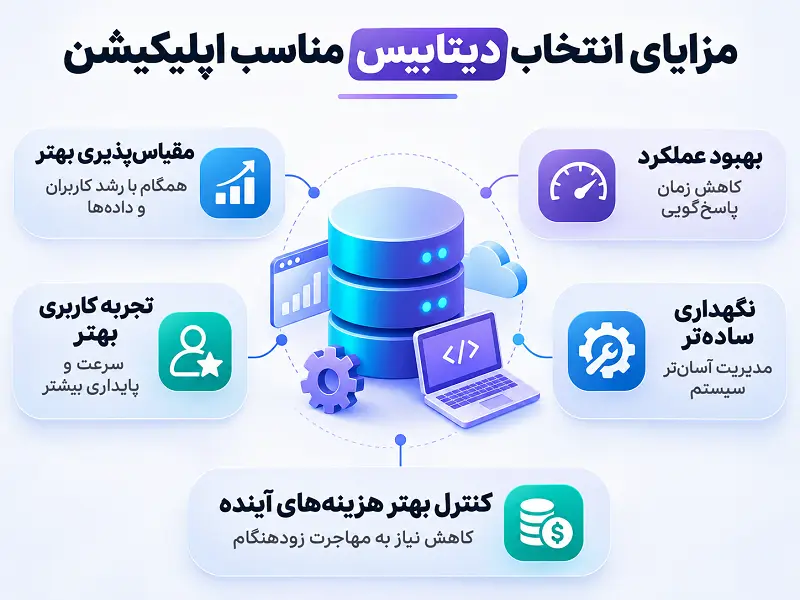
- مقیاس پذیری بهتر: دیتابیس می تواند متناسب با افزایش کاربران، حجم داده و تعداد درخواست ها توسعه پیدا کند.
- بهبود عملکرد: انتخاب فناوری متناسب با الگوی دسترسی به داده ها می تواند به کاهش زمان پاسخ گویی کمک کند.
- تجربه کاربری بهتر: عملکرد مناسب دیتابیس می تواند بر سرعت و پایداری بخش های مختلف اپلیکیشن اثر بگذارد.
- نگهداری ساده تر: انتخاب دیتابیس متناسب با نیازهای پروژه، می تواند پیچیدگی های مدیریت و نگهداری سیستم را کاهش دهد.
- کنترل بهتر هزینه های آینده: انتخاب صحیح می تواند نیاز به تغییرات اساسی در معماری یا مهاجرت زودهنگام را کاهش دهد.
مشکلات ناشی از انتخاب دیتابیس نامناسب
انتخاب اشتباه ممکن است در مراحل ابتدایی توسعه مشکل جدی ایجاد نکند، اما با رشد اپلیکیشن، محدودیت های آن آشکار شود. برخی از پیامدهای احتمالی عبارت اند از:
- کاهش عملکرد: دیتابیس ممکن است نتواند حجم داده یا تعداد درخواست های موردنیاز اپلیکیشن را به خوبی مدیریت کند.
- افزایش هزینه های زیرساخت و نگهداری: جبران محدودیت های دیتابیس ممکن است به منابع سخت افزاری یا نیروی فنی بیشتری نیاز داشته باشد.
- مشکلات مقیاس پذیری: رشد کاربران و داده ها ممکن است فشار بیشتری به معماری وارد کند و توسعه سیستم را دشوارتر سازد.
- کاهش دسترس پذیری: فشار بیش از ظرفیت یا طراحی نامناسب می تواند احتمال اختلال در سرویس را افزایش دهد.
- هزینه و پیچیدگی مهاجرت: اگر دیتابیس دیگر پاسخ گوی نیازهای پروژه نباشد، انتقال داده ها و تغییر بخش های وابسته به آن می تواند زمان و منابع قابل توجهی نیاز داشته باشد.
بنابراین، انتخاب دیتابیس مناسب اپلیکیشن باید با توجه به نیازهای فعلی پروژه و مسیر توسعه آن انجام شود.
چه عواملی در انتخاب دیتابیس مناسب اپلیکیشن مؤثر هستند؟
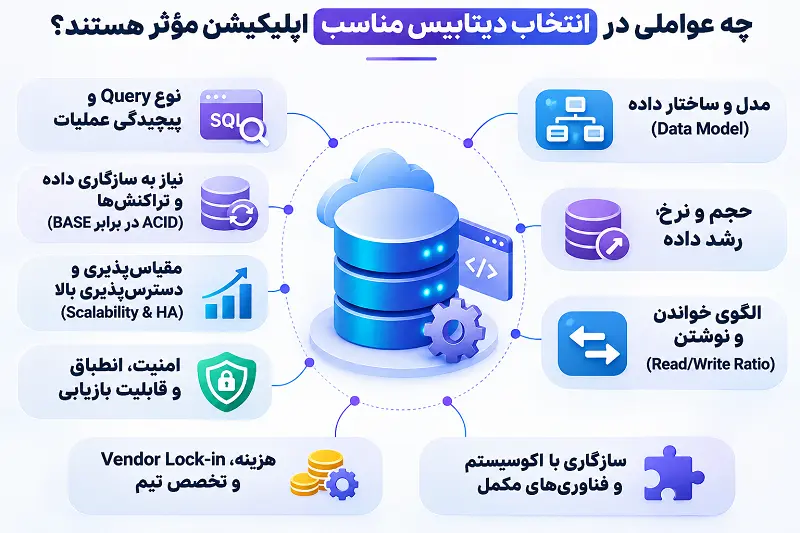
انتخاب پایگاه داده مناسب برای اپلیکیشن به مجموعه ای از معیارهای فنی و عملیاتی بستگی دارد که بر نحوه ذخیره سازی، بازیابی و مدیریت داده ها تأثیر می گذارند. مدل و حجم داده ها، الگوی خواندن و نوشتن، پیچیدگی Queryها، الزامات تراکنشی، مقیاس پذیری، امنیت و هزینه از مهم ترین معیارهای این تصمیم هستند.
۱. مدل و ساختار داده (Data Model)
نوع داده و ارتباط میان موجودیت ها، یکی از نخستین معیارهای انتخاب دیتابیس است.
- داده های ساختاریافته و دارای روابط مشخص، معمولاً با دیتابیس های رابطه ای (SQL) سازگاری بیشتری دارند.
- داده های نیمه ساختاریافته و اسناد JSON با ساختار متغیر، می توانند از انعطاف دیتابیس های Document بهره ببرند.
- داده های پیوسته و وابسته به زمان، مانند اطلاعات سنسورها، در برخی کاربردها با دیتابیس هایTime-Series بهتر مدیریت می شوند.
- اپلیکیشن های هوش مصنوعی که به ذخیره Embedding و جست وجوی شباهت نیاز دارند، می توانند از دیتابیس های Vector یا قابلیت های Vector دیتابیس های عمومی استفاده کنند.
بنابراین قبل از انتخاب موتور دیتابیس، باید مدل داده و نحوه ارتباط اطلاعات در اپلیکیشن مشخص شود.
۲. حجم و نرخ رشد داده
حجم فعلی اطلاعات به تنهایی کافی نیست و باید نرخ رشد داده و تعداد کاربران در آینده نیز در نظر گرفته شود. دیتابیسی که برای حجم فعلی مناسب است، ممکن است با رشد اپلیکیشن به محدودیت برسد.
در این مرحله باید قابلیت هایی مانند Partitioning، Replication،Sharding و توزیع داده و همچنین تأثیر افزایش حجم اطلاعات بر عملکرد بررسی شود.
۳. الگوی خواندن و نوشتن (Read/Write Ratio)
برخی اپلیکیشن ها بیشتر با عملیات خواندن سروکار دارند و برخی دیگر حجم زیادی از داده را به صورت مداوم ثبت یا به روزرسانی می کنند.
برای مثال، یک پلتفرم محتوامحور ممکن استRead-Heavy باشد، در حالی که سیستم های Logging یا IoT می توانندWrite-Heavy باشند. بنابراین باید بررسی شود دیتابیس انتخابی با الگوی واقعی بار کاری اپلیکیشن چه عملکردی دارد و معماری و موتور ذخیره سازی آن تا چه اندازه با این الگو سازگار است.
۴. نوع Query و پیچیدگی عملیات
نوع Queryها به اندازه تعداد آن ها اهمیت دارد. اگر اپلیکیشن به Joinهای پیچیده، فیلترهای ترکیبی، Aggregation یا Queryهای تحلیلی نیاز داشته باشد، قابلیت های پردازشی دیتابیس اهمیت بیشتری پیدا می کند.
در این بخش باید عواملی مانند Latency، Throughput، Indexing،Query Optimization و مدیریت درخواست های هم زمان بررسی شوند. در پروژه های حساس نیز بهتر است دیتابیس با Queryها و الگوهای دسترسی واقعی اپلیکیشن Benchmark شود.
۵. نیاز به سازگاری داده و تراکنش ها؛ ACID در برابر BASE
باید مشخص شود اپلیکیشن تا چه اندازه به سازگاری دقیق داده و تراکنش های قابل اتکا نیاز دارد.
ویژگی هایACID شامل Atomicity، Consistency،Isolation و Durability هستند و در بسیاری از دیتابیس های رابطه ای و برخی دیتابیس های غیررابطه ای پشتیبانی می شوند. این قابلیت ها برای کاربردهایی مانند پرداخت، تراکنش های مالی و مدیریت موجودی اهمیت زیادی دارند.
در مقابل، برخی سیستم های توزیع شده از الگوهای سازگاری انعطاف پذیرتری مانندEventual Consistency استفاده می کنند که می تواند در بعضی سناریوها به دسترس پذیری و مقیاس پذیری کمک کند. بنابراین انتخاب این رویکردها باید بر اساس حساسیت داده و نیاز واقعی اپلیکیشن انجام شود، نه صرفاً بر اساس SQL یا NoSQL بودن دیتابیس.
۶. مقیاس پذیری و دسترس پذیری بالا (Scalability & HA)
دیتابیس باید بتواند همراه با افزایش کاربران و داده ها رشد کند.
مقیاس پذیری عمودی (Vertical Scaling) با افزایش منابع یک سرور انجام می شود و معمولاً ساده تر است، اما به محدودیت های سخت افزاری وابسته است. در مقابل، مقیاس پذیری افقی (Horizontal Scaling) با توزیع بار یا داده میان چند سرور انجام می شود و برای برخی سیستم های بزرگ و توزیع شده مناسب تر است، هرچند می تواند پیچیدگی عملیاتی بیشتری داشته باشد.
همچنین باید قابلیت های High Availability،Replication و Clustering بررسی شوند. HA با Disaster Recovery یکسان نیست؛ HA بر حفظ دسترس پذیری سرویس تمرکز دارد، در حالی که Disaster Recovery به بازیابی سیستم پس از یک رخداد جدی مربوط می شود.
۷. امنیت، انطباق و قابلیت بازیابی
امنیت دیتابیس باید متناسب با نوع داده و نیازهای اپلیکیشن بررسی شود. قابلیت هایی مانند کنترل دسترسی مبتنی بر نقش (RBAC)، احراز هویت (Authentication)، ممیزی رویدادها (Audit Logging) و رمزنگاری داده ها (Encryption) اهمیت دارند.
همچنین باید نحوه محافظت از داده در زمان انتقال و ذخیره سازی مشخص شود؛ برای مثال رمزنگاری (TLS) برای داده در حال انتقال و روش هایی مانند رمزنگاری شفاف داده ها (TDE) برای داده ذخیره شده کاربرد دارند. در اپلیکیشن هایی که با داده های حساس سروکار دارند، الزامات قانونی و استانداردهایی مانند GDPR یاPCI DSS نیز باید بررسی شوند.
در کنار امنیت، وجود Backup،Recovery و Disaster Recovery برای کاهش خطر از دست رفتن داده اهمیت دارد.
۸. سازگاری با اکوسیستم و فناوری های مکمل
دیتابیس بخشی از معماری اپلیکیشن موبایل است و باید با سایر اجزای سیستم سازگار باشد. برای مثال، ممکن است اپلیکیشن بهRedis برای Caching،Kafka برای پیام رسانی و Streaming یا ابزارهای ETL نیاز داشته باشد.
کیفیت Driverها، APIها، Connectorها و ابزارهای توسعه و مانیتورینگ نیز باید بررسی شود؛ زیرا یکپارچه سازی دشوار می تواند هزینه و زمان توسعه را افزایش دهد.
۹. هزینه،Vendor Lock-in و تخصص تیم
هزینه دیتابیس فقط به License یا قیمت سرویس محدود نمی شود و باید زیرساخت، ذخیره سازی، پهنای باند، مانیتورینگ، پشتیبان گیری و نیروی انسانی نیز در نظر گرفته شوند.
همچنین استفاده گسترده از قابلیت های اختصاصی یک Vendor می تواند وابستگی ایجاد کند و در صورت نیاز به مهاجرت، هزینه و پیچیدگی انتقال را افزایش دهد.
در نهایت، تخصص تیم فنی نیز اهمیت زیادی دارد. دیتابیسی که تیم تجربه کافی در طراحی، بهینه سازی، مانیتورینگ و رفع مشکلات آن ندارد، لزوماً بهترین گزینه برای پروژه نیست.
مقایسه دیتابیس های SQL و NoSQL؛ کدام مدل برای اپلیکیشن شما مناسب تر است؟
SQL و NoSQL دو رویکرد اصلی برای ذخیره و مدیریت داده در اپلیکیشن ها هستند. تفاوت آن ها فقط به نحوه ذخیره اطلاعات محدود نمی شود و مواردی مانند مدل داده، ساختار Schema، نوع Query، روابط میان داده ها، تراکنش ها و مقیاس پذیری را نیز شامل می شود.
در دیتابیس های SQL، داده ها معمولاً در جدول های مرتبط با ساختار مشخص ذخیره می شوند؛ در حالی که NoSQL مجموعه ای از مدل های غیررابطه ای مانند Document، Key-Value،Wide-Column و Graph را دربرمی گیرد. انتخاب میان این دو رویکرد باید بر اساس نیاز واقعی اپلیکیشن، نوع داده و الگوی دسترسی به اطلاعات انجام شود.
SQL و NoSQL چه تفاوتی با یکدیگر دارند؟
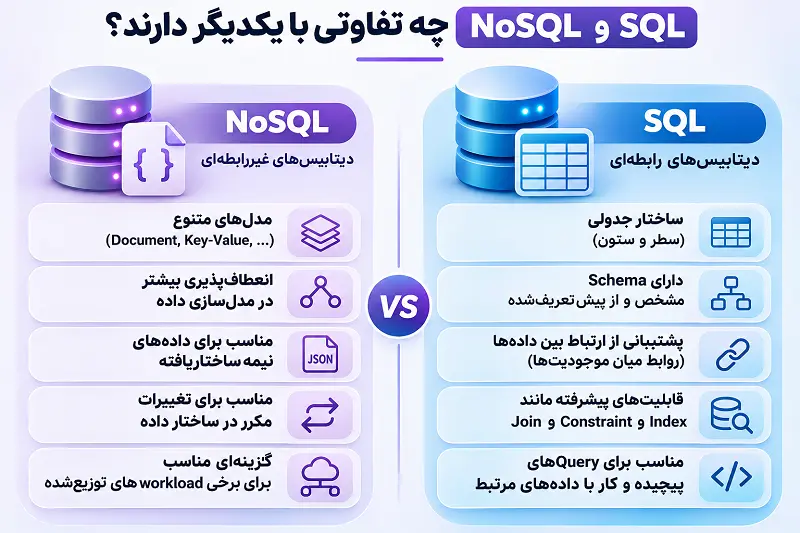
دیتابیس هایSQL یا رابطه ای، اطلاعات را در قالب جدول هایی شامل سطر و ستون ذخیره می کنند و ارتباط میان موجودیت ها نیز در ساختار دیتابیس تعریف می شود. Schema در این دیتابیس ها معمولاً از قبل مشخص است و قابلیت هایی مانند Join، Constraint،Index و Queryهای پیچیده برای کار با داده های مرتبط اهمیت زیادی دارند.
در مقابل،NoSQL به یک نوع دیتابیس خاص اشاره نمی کند و مدل های مختلفی مانند Document، Key-Value،Wide-Column و Graph را شامل می شود. این دیتابیس ها معمولاً انعطاف بیشتری در مدل سازی داده دارند و می توانند برای داده های نیمه ساختاریافته، تغییرات مکرر در ساختار اطلاعات یا برخی workloadهای توزیع شده مناسب باشند.
| NoSQL | SQL | معیار |
| Document، Key-Value، Wide-Column،Graph و ... | رابطه ای و مبتنی بر جدول | مدل داده |
| معمولاً انعطاف پذیرتر | معمولاً از پیش تعریف شده | Schema |
| معمولاً مبتنی بر الگوی دسترسی و مدل داده | مناسب برای روابط وJoinهای پیچیده | روابط میان داده ها |
| قابلیت های تراکنشی و سازگاری بسته به دیتابیس متفاوت است | پشتیبانی قوی از ACID در بسیاری از سیستم ها | تراکنش |
| در بسیاری از محصولات با تمرکز بر توزیع افقی | عمودی و در برخی سیستم ها افقی | مقیاس پذیری |
| داده های انعطاف پذیر، توزیع شده و workloadهای تخصصی | سیستم های تراکنشی و داده های مرتبط | کاربرد رایج |
این تفاوت ها مطلق نیستند. برخی دیتابیس های NoSQL از تراکنش های ACID پشتیبانی می کنند و دیتابیس های رابطه ای نیز بسته به محصول و معماری می توانند از قابلیت های توزیع شده و مقیاس پذیری افقی بهره ببرند.
تفاوت SQL و NoSQL در مقیاس پذیری و عملکرد
مقیاس پذیری یکی از معیارهای مهم انتخاب دیتابیس اپلیکیشن است، اما نمی توان آن را به شکل ساده به SQL یا NoSQL نسبت داد. برخی دیتابیس های رابطه ای می توانند با Replication،Partitioning و Sharding در معماری های بزرگ مقیاس پیدا کنند و بسیاری از دیتابیس های NoSQL نیز با تمرکز بر توزیع داده میان چند Node طراحی شده اند.
از طرف دیگر، عملکرد دیتابیس به عواملی مانند نوع Query، نسبت خواندن به نوشتن، Indexگذاری، حجم داده، تعداد درخواست های هم زمان و نوع workload وابسته است. به همین دلیل، برای پروژه های حساس بهتر است عملکرد دیتابیس با داده و Queryهای نزدیک به شرایط واقعی بررسی شود.
چه زمانی دیتابیس SQL انتخاب مناسب تری است؟
پایگاه های داده SQL معمولاً زمانی انتخاب مناسبی هستند که ارتباط میان داده ها، یکپارچگی اطلاعات و تراکنش ها اهمیت زیادی داشته باشد. این رویکرد برای اپلیکیشن هایی که با داده های ساختاریافته و روابط مشخص سروکار دارند، گزینه ای رایج است.
SQL می تواند انتخاب مناسبی باشد وقتی:
- سازگاری و یکپارچگی داده ها اهمیت بالایی داشته باشد.
- اپلیکیشن به Joinهای پیچیده و تراکنش های چندمرحله ای نیاز داشته باشد.
- ساختار داده ها از قبل مشخص و نسبتاً پایدار باشد.
- محدودیت ها و قواعد مشخصی برای داده ها نیاز باشد.
- اپلیکیشن شامل سیستم هایی مانند بانکداری، ERP، حسابداری یا مدیریت موجودی باشد.
- Queryهای تحلیلی یا عملیاتی پیچیده روی داده های مرتبط اجرا شوند.
برای مثال، در یک سیستم فروشگاهی، ارتباط میان مشتری، سفارش، محصول، پرداخت و موجودی اهمیت زیادی دارد. در چنین شرایطی، مدل رابطه ای و قابلیت های تراکنشی دیتابیس SQL می تواند مدیریت داده ها را ساده تر کند.
چه زمانی دیتابیس NoSQL انتخاب مناسب تری است؟
NoSQL زمانی می تواند انتخاب مناسب تری باشد که انعطاف پذیری مدل داده، توزیع اطلاعات یا یک الگوی دسترسی خاص اهمیت بیشتری داشته باشد. البته این موضوع به نوع دیتابیس NoSQL نیز وابسته است؛ زیرا Document، Key-Value،Wide-Column و Graph کاربردهای یکسانی ندارند.
NoSQL می تواند برای اپلیکیشن هایی مناسب باشد که:
- به مقیاس پذیری افقی و توزیع داده نیاز دارند.
- با داده های نیمه ساختاریافته یا دارای Schema انعطاف پذیر کار می کنند.
- ساختار داده ها ممکن است در طول توسعه اپلیکیشن مرتب تغییر کند.
- حجم زیادی از داده با یک الگوی دسترسی مشخص تولید یا پردازش می شود.
- به پردازش بلادرنگ یا تأخیر پایین در یک workload مشخص نیاز دارند.
- مدل داده با ساختارهای Document، Key-Value،Wide-Column یا Graph تناسب بیشتری دارد.
برای نمونه، یک دیتابیس Document می تواند برای اپلیکیشنی که اطلاعات کاربران یا محتوا ساختار متغیری دارد مناسب باشد، در حالی که یک دیتابیس Key-Value ممکن است برای دسترسی سریع به داده های مشخص یا یک workload خاص انتخاب شود.
در نتیجه، بزرگ بودن حجم داده به تنهایی دلیل کافی برای انتخاب NoSQL نیست. باید مشخص شود مدل داده، نوع درخواست ها، نیازهای سازگاری و معماری سیستم واقعاً با قابلیت های دیتابیس موردنظر تناسب دارند.
SQL یا NoSQL؛ کدام یک برای اپلیکیشن شما مناسب تر است؟
برای انتخاب میان SQL و NoSQL نمی توان یک پاسخ ثابت برای همه اپلیکیشن ها ارائه کرد. بهتر است معیارهای زیر را در کنار یکدیگر بررسی کنید:
- آیا داده ها روابط پیچیده و مشخصی با یکدیگر دارند؟
- آیا تراکنش ها و یکپارچگی داده اهمیت بالایی دارند؟
- آیا ساختار داده ثابت است یا مرتب تغییر می کند؟
- آیا اپلیکیشن به مقیاس پذیری افقی و معماری توزیع شده نیاز دارد؟
- Queryهای اصلی سیستم پیچیده اند یا بیشتر بر دسترسی سریع به داده های مشخص تمرکز دارند؟
- حجم و سرعت تولید داده در آینده چگونه خواهد بود؟
اگر نیازهای پروژه بیشتر به سمت روابط داده ای، تراکنش، یکپارچگی و Queryهای پیچیده باشد، یک دیتابیس SQL معمولاً انتخاب مناسبی است. اگر انعطاف پذیری Schema، توزیع داده یا یک workload خاص اولویت داشته باشد، یکی از مدل های NoSQL می تواند گزینه بهتری باشد.
NewSQL چه جایگاهی در انتخاب دیتابیس دارد؟
انتخاب دیتابیس فقط بهSQL یا NoSQL محدود نمی شود. NewSQL به گروهی از دیتابیس های رابطه ای و توزیع شده اشاره دارد که تلاش می کنند قابلیت های تراکنشی و سازگاری دیتابیس های SQL را با مقیاس پذیری افقی و معماری توزیع شده ترکیب کنند.
این رویکرد می تواند برای اپلیکیشن هایی مناسب باشد که هم به تراکنش های ACID و روابط داده ای نیاز دارند و هم باید حجم بالایی از درخواست ها را در یک معماری توزیع شده مدیریت کنند. CockroachDB و YugabyteDB از نمونه های شناخته شده این حوزه هستند.
بنابراین اگر نیازهای اپلیکیشن با یک دیتابیس رابطه ای معمولی برطرف نمی شود، اما استفاده از یک دیتابیس NoSQL نیز به دلیل نیازهای تراکنشی و یکپارچگی داده مناسب نیست،NewSQL می تواند یکی از گزینه های قابل بررسی باشد.
آیا می توان از SQL و NoSQL به صورت هم زمان استفاده کرد؟
در برخی معماری ها، استفاده هم زمان از SQL و NoSQL با رویکردPolyglot Persistence انجام می شود. برای مثال، دیتابیس رابطه ای می تواند مسئول داده های اصلی و تراکنش ها باشد و یک دیتابیس دیگر برای Caching، جست وجوی تخصصی، داده های زمانی یا workload خاص مورد استفاده قرار گیرد.
این معماری انعطاف بیشتری ایجاد می کند، اما در مقابل پیچیدگی عملیاتی را نیز افزایش می دهد. بنابراین استفاده از چند دیتابیس باید زمانی انجام شود که مزیت آن برای اپلیکیشن، هزینه و پیچیدگی اضافه شده را توجیه کند.
پس از مشخص شدن رویکرد مناسب و گزینه های قابل بررسی، می توان سراغ انتخاب موتور دیتابیس رفت. در این مرحله، گزینه هایی مانند PostgreSQL،MySQL و MongoDB را می توان از نظر ساختار داده، Query، تراکنش، عملکرد، مقیاس پذیری و کاربردهای مناسب با یکدیگر مقایسه کرد.
محبوب ترین و پرکاربردترین دیتابیس ها در توسعه اپلیکیشن
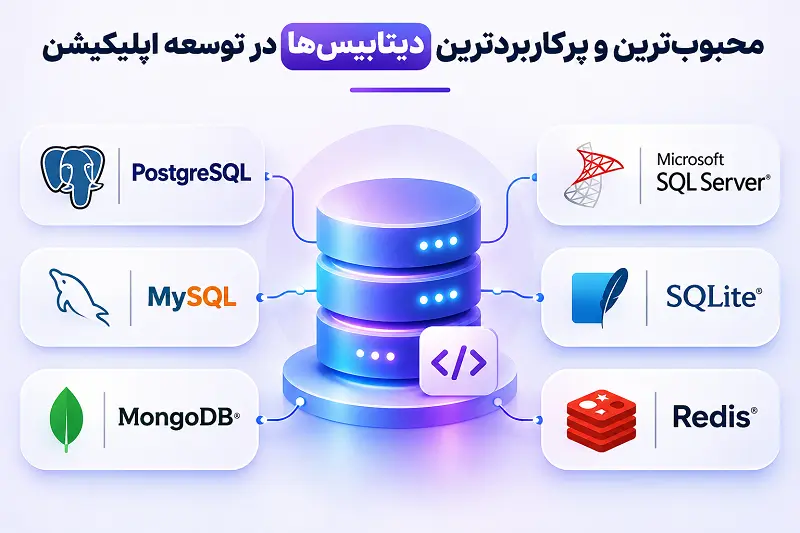
هر دیتابیس برای نوع خاصی از داده، الگوی دسترسی و نیازهای معماری طراحی شده است. به همین دلیل، نمی توان یک گزینه را برای همه اپلیکیشن ها بهترین دانست. PostgreSQL، MySQL، MongoDB، Microsoft SQL Server،SQLite و Redis از دیتابیس های شناخته شده در توسعه نرم افزار هستند، اما تفاوت آن ها در مدل داده، نحوه پردازش اطلاعات و کاربردهایی است که برای آن ها مناسب ترند.
در کنار این گزینه ها، دیتابیس ها و موتورهای تخصصی مانند Cassandra، ClickHouse، Neo4j، InfluxDB و Elasticsearch نیز برای نیازهایی مانند پردازش توزیع شده، تحلیل داده، مدیریت داده های گرافی، داده های زمانی و جست وجوی متنی استفاده می شوند. بنابراین، قبل از مقایسه دیتابیس ها بهتر است جایگاه و کاربرد اصلی هرکدام را بشناسیم.
PostgreSQL
PostgreSQL یک دیتابیس رابطه ای متن باز است که از SQL استفاده می کند و امکانات گسترده ای برای مدیریت داده های ساختاریافته و نیمه ساختاریافته دارد. پشتیبانی از تراکنش ها، انواع داده متنوع، ایندکس های پیشرفته و قابلیت هایی مانند JSON/JSONB باعث شده است PostgreSQL برای پروژه هایی با منطق داده ای پیچیده گزینه ای قدرتمند باشد.
این دیتابیس در اپلیکیشن های سازمانی، سامانه های مالی، پلتفرم های وب و پروژه هایی که به تراکنش های قابل اعتماد و کوئری های پیچیده نیاز دارند، کاربرد زیادی دارد. قابلیت هایی مانند PostGIS نیز امکان استفاده از PostgreSQL را در پروژه های مکانی و جغرافیایی فراهم می کنند.
MySQL
MySQL یکی از دیتابیس های رابطه ای شناخته شده در توسعه وب و نرم افزار است. این دیتابیس ازSQL استفاده می کند و موتور InnoDB امکاناتی مانند تراکنش، کلید خارجی و قفل گذاری در سطح ردیف را ارائه می دهد.
سادگی نسبی، اکوسیستم گسترده و سازگاری با فناوری های رایج وب باعث شده است MySQL در انواع وب سایت ها، فروشگاه های اینترنتی، سیستم های مدیریت محتوا و اپلیکیشن های مبتنی بر معماری های متداول سمت سرور استفاده شود.
MySQL برای پروژه هایی که ساختار داده مشخص، روابط قابل تعریف و الگوهای دسترسی شناخته شده دارند، می تواند انتخاب مناسبی باشد. با این حال، انتخاب بین MySQL و گزینه هایی مانند PostgreSQL باید بر اساس عواملی مانند پیچیدگی کوئری ها، نیازهای تراکنشی، مقیاس پروژه و تخصص تیم توسعه انجام شود.
MongoDB
MongoDB یک دیتابیس سندمحور از نوع NoSQL است که اطلاعات را در قالب اسناد BSON ذخیره می کند. برخلاف دیتابیس های رابطه ای که داده ها را معمولاً در جدول ها و ردیف های مرتبط سازمان دهی می کنند،MongoDB امکان مدل سازی داده ها در قالب اسناد با ساختار انعطاف پذیرتر را فراهم می کند.
این ویژگی برای اپلیکیشن هایی که ساختار داده آن ها در طول زمان تغییر می کند یا داده های مرتبط را می توان در قالب یک سند مدل سازی کرد، مفید است. MongoDB همچنین قابلیت هایی برای توزیع داده، replication و مقیاس پذیری در اختیار پروژه ها قرار می دهد.
با این حال، انتخاب MongoDB صرفاً به دلیل NoSQL بودن یا حجم زیاد داده منطقی نیست. مدل داده، نوع کوئری ها، نیاز به تراکنش و الگوی خواندن و نوشتن باید مشخص کند که یک دیتابیس سندمحور برای پروژه مناسب است یا خیر.
Microsoft SQL Server
Microsoft SQL Server یک دیتابیس رابطه ای است که در بسیاری از سامانه های سازمانی و محیط هایی که با فناوری های مایکروسافت کار می کنند، مورد استفاده قرار می گیرد. این سیستم علاوه بر قابلیت های مربوط به پردازش تراکنش ها، امکاناتی برای گزارش گیری، تحلیل داده و مدیریت بارهای کاری سازمانی ارائه می دهد.
SQL Server می تواند برای اپلیکیشن هایی که به داده های رابطه ای، تراکنش های قابل اعتماد، کنترل دسترسی و یکپارچگی با زیرساخت های سازمانی نیاز دارند، گزینه مناسبی باشد.
SQLite
SQLite با دیتابیس های سرورمحوری مانند PostgreSQL و MySQL تفاوت دارد. این سیستم یک موتور دیتابیس رابطه ایEmbedded و Serverless است که مستقیماً درون اپلیکیشن اجرا می شود و برای کار کردن به یک سرور دیتابیس جداگانه نیاز ندارد.
SQLite به دلیل حجم کم و معماری ساده، در طراحی اپلیکیشن های موبایل، نرم افزارهای دسکتاپ، ذخیره سازی محلی و سناریوهایOffline-first کاربرد دارد. در چنین پروژه هایی، اطلاعات می تواند روی دستگاه کاربر ذخیره شود و اپلیکیشن بدون اتصال دائمی به دیتابیس مرکزی نیز به داده های محلی دسترسی داشته باشد.
بنابراین SQLite را نباید صرفاً نسخه ساده تری از PostgreSQL یا MySQL در نظر گرفت؛ این فناوری برای ذخیره سازی محلی و Embedded طراحی شده و جایگاه متفاوتی در معماری اپلیکیشن دارد.
Redis
Redis یک سیستم ذخیره سازی داده در حافظه و مبتنی بر مدل Key-Value است که از ساختارهایی مانند String، Hash، List،Set و Sorted Set پشتیبانی می کند. یکی از کاربردهای رایج آن، نگهداری موقت داده هایی است که اپلیکیشن باید به آن ها دسترسی سریع داشته باشد.
Redis می تواند در کش، مدیریت Session، صف ها و برخی سناریوهای پردازش رویداد به کار گرفته شود. همچنین امکاناتی برای ماندگاری داده و replication دارد.
با وجود این،Redis را نباید در همه پروژه ها جایگزین مستقیم دیتابیس اصلی دانست. در بسیاری از معماری ها، PostgreSQL یا MySQL مسئول نگهداری داده های اصلی هستند و Redis در کنار آن ها برای یک نیاز مشخص مانند caching یا مدیریت Session استفاده می شود.
سایر دیتابیس ها و موتورهای تخصصی
برخی فناوری های پایگاه داده برای الگوهای خاصی از داده و پردازش طراحی شده اند و معمولاً رقیب مستقیم دیتابیس های عمومی مانند PostgreSQL یا MySQL محسوب نمی شوند:
| دیتابیس | توضیحات |
| Cassandra | یک دیتابیس توزیع شده Wide-Column است که برای سیستم هایی با حجم بالای نوشتن و نیاز به مقیاس پذیری افقی طراحی شده است. |
| ClickHouse | یک دیتابیس ستونی و تحلیلی است که برای پردازش حجم زیادی از داده در بارهای کاری OLAP و تحلیل های سریع کاربرد دارد. |
| Neo4j | یک دیتابیس گرافی است که برای مدل سازی روابط میان موجودیت ها، مانند سیستم های پیشنهاددهنده، تشخیص تقلب و Knowledge Graph استفاده می شود. |
| InfluxDB | برای داده های Time-Series مانند متریک های سیستم، داده های حسگرها و رویدادهای دارای timestamp طراحی شده است. |
| Elasticsearch | بیشتر به عنوان موتور جست وجو و تحلیل داده شناخته می شود و در جست وجوی متنی، تحلیل لاگ ها و برخی سناریوهای جست وجوی پیچیده کاربرد دارد. |
در معماری های واقعی، حتی ممکن است چند فناوری در کنار یکدیگر استفاده شوند؛ برای مثال، یک دیتابیس رابطه ای برای نگهداری داده های اصلی،Redis برای کش و Elasticsearch برای جست وجوی متنی. بنابراین، انتخاب دیتابیس مناسب باید بر اساس نیاز واقعی اپلیکیشن و نوع بار کاری انجام شود، نه صرفاً میزان محبوبیت یک فناوری.
در میان گزینه های عمومی و پرکاربرد، PostgreSQL،MySQL و MongoDB از مهم ترین گزینه هایی هستند که باید هنگام طراحی بسیاری از اپلیکیشن ها با یکدیگر مقایسه شوند. تفاوت این سه دیتابیس در مدل داده، تراکنش ها، انعطاف پذیری، نوع کوئری ها و نحوه مقیاس پذیری می تواند انتخاب نهایی را به طور قابل توجهی تغییر دهد.
مقایسه جامع PostgreSQL،MySQL و MongoDB؛ بررسی تفاوت ها، عملکرد و معیارهای انتخاب
بعد از شناخت دیتابیس های پرکاربرد، حالا می توان مقایسه دیتابیس ها را بر اساس معیارهایی انجام داد که مستقیماً روی معماری و عملکرد اپلیکیشن تأثیر می گذارند. PostgreSQL و MySQL دو دیتابیس رابطه ای هستند، در حالی که MongoDB از مدل سندمحور استفاده می کند. همین تفاوت در مدل داده باعث می شود نحوه طراحی Schema، اجرای Query، مدیریت روابط و مقیاس پذیری در این سه گزینه یکسان نباشد.
در نتیجه، انتخاب پایگاه داده مناسب نباید صرفاً بر اساس اینکه کدام گزینه «سریع تر» یا «محبوب تر» است انجام شود. نوع داده، پیچیدگی روابط، الگوی خواندن و نوشتن، نیازهای تراکنشی و مسیر رشد اپلیکیشن معیارهای تعیین کننده این تصمیم هستند.
مدل داده و ساختار Schema؛ رابطه ای یا سندمحور؟
PostgreSQL وMySQL از مدل رابطه ای استفاده می کنند. داده ها در جدول هایی شامل سطر و ستون ذخیره می شوند و مفاهیمی مانند کلید اصلی (Primary Key)، کلید خارجی (Foreign Key) و رابطه بین جداول، بخش مهمی از ساختار داده را تشکیل می دهند. این مدل برای اپلیکیشن هایی که روابط مشخص و وابستگی زیادی بین داده ها دارند، انتخاب مناسبی است.
- PostgreSQL علاوه بر ساختار رابطه ای، از داده های JSON و JSONB نیز پشتیبانی می کند؛ بنابراین می توان در کنار جداول رابطه ای، داده های نیمه ساختاریافته را نیز مدیریت کرد.
- MySQL نیز در کنار ساختار رابطه ای، قابلیت ذخیره و پردازش داده های JSON را ارائه می دهد.
- MongoDB یک دیتابیس سندمحور است و داده ها را به شکل Documentهای BSON ذخیره می کند. این ساختار امکان ایجاد Schema انعطاف پذیرتری را فراهم می کند و برای داده هایی که ساختارشان در طول زمان تغییر می کند، می تواند مناسب باشد.
انعطاف پذیری Schema در MongoDB به معنی بدون ساختار بودن داده ها نیست. برای اسناد می توان محدودیت ها و قواعد مشخصی تعریف کرد و MongoDB نیز قابلیت Schema Validation را در اختیار توسعه دهندگان قرار می دهد.
تراکنش و ACID؛ کدام دیتابیس برای داده های حساس مناسب تر است؟
در اپلیکیشن هایی مانند فروشگاه اینترنتی، سامانه های مالی یا سیستم های مدیریت سفارش، حفظ صحت داده ها هنگام اجرای چند عملیات مرتبط اهمیت زیادی دارد. برای مثال، هنگام ثبت یک سفارش ممکن است لازم باشد موجودی کالا، اطلاعات سفارش و وضعیت پرداخت به صورت هماهنگ به روزرسانی شوند.
هر سه دیتابیس از تراکنش های ACID پشتیبانی می کنند، اما نحوه مدل سازی و استفاده از تراکنش ها در آن ها متفاوت است.
- PostgreSQL از تراکنش های ACID و MVCC پشتیبانی می کند و MVCC به مدیریت هم زمانی دسترسی ها و کاهش تداخل میان عملیات خواندن و نوشتن کمک می کند.
- MySQL در صورت استفاده از موتور InnoDB، از تراکنش های ACID، قفل گذاری در سطح سطر و Foreign Key پشتیبانی می کند.
- MongoDB نیز از تراکنش های ACID، از جمله تراکنش های چندسندی (Multi-Document Transactions)، پشتیبانی می کند. در برخی سناریوها نیز می توان داده های مرتبط را در یک Document مدل کرد و نیاز به تراکنش های چندسندی را کاهش داد.
بنابراین، تصور اینکه NoSQL به معنی نداشتن ACID است، دقیق نیست. انتخاب بین دیتابیس های رابطه ای و سندمحور باید بر اساس ساختار داده، میزان ارتباط بین موجودیت ها و نحوه استفاده از تراکنش ها انجام شود.
Query و Indexing؛ کدام دیتابیس برای عملیات پیچیده مناسب تر است؟
نوع Queryهایی که اپلیکیشن اجرا می کند، یکی از معیارهای مهم در انتخاب دیتابیس مناسب است. هرچه Queryها پیچیده تر و روابط بین داده ها بیشتر باشد، قابلیت های موتور Query و نحوه طراحی Index اهمیت بیشتری پیدا می کند.
- PostgreSQL از SQL و قابلیت هایی مانند Join، Subquery،Window Function و انواع مختلف Index پشتیبانی می کند. B-Tree، Hash، GIN،GiST و BRIN از انواع Indexهای قابل استفاده در PostgreSQL هستند و هرکدام برای الگوهای خاصی از داده و Query کاربرد دارند.
- MySQL نیز از SQL،Join و انواع Index پشتیبانی می کند و برای طیف گسترده ای از Queryهای رایج در اپلیکیشن های وب و سیستم های رابطه ای مناسب است.
- MongoDB به جای SQL از MongoDB Query Language یا MQL استفاده می کند و برای پردازش و تحلیل داده ها از Aggregation Pipeline بهره می برد. قابلیت هایی مانند Indexهای تک فیلدی،Compound و Multikey نیز امکان بهینه سازی Queryها را فراهم می کنند.
البته وجود Index به تنهایی به معنی افزایش عملکرد نیست. Index مناسب می تواند سرعت اجرای Query را بهبود دهد، اما تعداد زیاد Indexها فضای ذخیره سازی بیشتری مصرف می کند و می تواند هزینه عملیات نوشتن را افزایش دهد. بنابراین طراحی Index باید بر اساس الگوی واقعی دسترسی به داده انجام شود.
عملکرد و الگوی خواندن و نوشتن (Workload)
در مقایسه PostgreSQL و MySQL یا مقایسه هرکدام از این گزینه ها با MongoDB، نمی توان یک دیتابیس را به طور مطلق سریع تر از دیگری دانست. عملکرد به نوع Workload، حجم داده، Queryها، سخت افزار، تنظیمات و معماری اپلیکیشن بستگی دارد.
- MySQL می تواند برای بسیاری از اپلیکیشن های وب با ساختار داده مشخص و Workloadهای خواندن محور عملکرد مناسبی داشته باشد.
- PostgreSQL برای پروژه هایی که Queryهای پیچیده، محاسبات پیشرفته یا پردازش چندلایه روی داده های رابطه ای دارند، قابلیت های گسترده ای ارائه می دهد.
- MongoDB برای داده هایی که ساختار سندمحور و انعطاف پذیر دارند و وابستگی زیادی به Joinهای رابطه ای ندارند، می تواند گزینه مناسبی باشد.
بنابراین سؤال اصلی این نیست که «کدام دیتابیس سریع تر است؟»؛ بلکه باید مشخص کرد کدام دیتابیس با الگوی خواندن و نوشتن اپلیکیشن سازگاری بیشتری دارد.
مقیاس پذیری،Replication و Sharding
با افزایش تعداد کاربران و حجم داده، معماری دیتابیس نیز باید امکان توسعه داشته باشد. Replication، Partitioning،Sharding و استفاده از Replicaها از جمله روش هایی هستند که برای افزایش ظرفیت، دسترس پذیری یا توزیع بار مورد استفاده قرار می گیرند.
- MongoDB قابلیت Sharding را برای توزیع داده بین چند سرور ارائه می کند و در پروژه هایی که به توزیع افقی داده نیاز دارند، می تواند گزینه مناسبی باشد.
- PostgreSQL از Replication و Partitioning پشتیبانی می کند و برای سناریوهای مقیاس پذیری توزیع شده، راهکارها و ابزارهایی مانند Citus نیز وجود دارند.
- MySQL نیز از Replication و معماری های مختلف برای افزایش دسترس پذیری و مقیاس پذیری پشتیبانی می کند.
در نتیجه، مقیاس پذیری را نباید به یک دوگانه ساده بین SQL و NoSQL محدود کرد. نوع Workload، حجم داده، نیاز به High Availability، نحوه توزیع داده و معماری کلی سیستم باید هم زمان بررسی شوند.
جدول مقایسه فنی PostgreSQL، MySQL و MongoDB
| MongoDB | MySQL | PostgreSQL | معیار |
| سندمحور | رابطه ای | رابطه ای | مدل داده |
| NoSQL / Document Store | SQL / RDBMS | SQL / RDBMS | نوع پایگاه داده |
| اسناد BSON | جدول، سطر و ستون + JSON | جدول، سطر و ستون + JSON/JSONB | ساختار ذخیره سازی |
| انعطاف پذیر | ساختاریافته و قابل تعریف | ساختاریافته و قابل توسعه | ساختار Schema |
| MQL | SQL | SQL | زبان Query |
| پشتیبانی می شود؛ | پشتیبانی می شود؛ InnoDB | پشتیبانی می شود | تراکنش های ACID |
| با $lookup و رویکرد سندمحور | گسترده | گسترده | Join |
| Single-field، Compound،Multikey و ... | انواع Index متناسب با موتور و داده | B-Tree، Hash، GIN، GiST،BRIN و ... | روش های Indexing |
| Replica Set | پشتیبانی می شود | پشتیبانی می شود | Replication |
| Sharding داخلی | با معماری های مختلف | با ابزارها و معماری های مختلف | مقیاس پذیری افقی |
| داده های سندمحور، ساختارهای انعطاف پذیر و برخی Workloadهای توزیع شده | اپلیکیشن های وب و داده های رابطه ای | داده های رابطه ای پیچیده، تراکنشی و ترکیبی | سناریوهای مناسب |
PostgreSQL،MySQL یا MongoDB؛ کدام دیتابیس برای پروژه شما مناسب تر است؟
پاسخ به این سؤال به نیازهای پروژه بستگی دارد و نمی توان یک گزینه را برای همه اپلیکیشن ها بهترین دانست.
- PostgreSQL می تواند انتخاب مناسبی برای پروژه هایی باشد که روابط پیچیده بین داده ها، Queryهای پیشرفته، تراکنش های مهم و نیاز به قابلیت هایی مانند JSONB یا PostGIS دارند. انعطاف پذیری PostgreSQL باعث می شود بتوان از آن هم برای داده های رابطه ای و هم در برخی سناریوهای ترکیبی استفاده کرد.
- MySQL برای بسیاری از وب سایت ها، فروشگاه های اینترنتی و اپلیکیشن هایی که ساختار داده مشخص و روابط رابطه ای متعارف دارند، گزینه ای شناخته شده و پرکاربرد است. سادگی نسبی، اکوسیستم گسترده و پشتیبانی مناسب از Workloadهای رایج وب از عواملی هستند که می توانند انتخاب آن را توجیه کنند.
- MongoDB بیشتر زمانی مورد توجه قرار می گیرد که مدل داده سندمحور باشد، ساختار Documentها انعطاف پذیری بیشتری بخواهد یا معماری پروژه به توزیع افقی داده نیاز داشته باشد. در این حالت، طراحی داده بر اساس Document و الگوی دسترسی اهمیت زیادی پیدا می کند.
در برخی پروژه های بزرگ نیز الزاماً فقط یک دیتابیس انتخاب نمی شود. برای مثال، ممکن است PostgreSQL یا MySQL برای داده های اصلی و تراکنش ها،Redis برای Cache و Elasticsearch برای جست وجوی تخصصی استفاده شود. این رویکرد که بهPolyglot Persistence شناخته می شود، زمانی منطقی است که هر سیستم برای یک نیاز مشخص انتخاب شود و پیچیدگی عملیاتی آن با مزایای معماری تناسب داشته باشد.
به نقل از مارتین کلپمن، نویسنده کتاب Designing Data-Intensive Applications:
»There is no one database or tool that can do everything that our application requires – we use the best tool for the job, and for an application with a variety of features that implies using a variety of tools.
هیچ دیتابیس یا ابزاری وجود ندارد که بتواند تمام نیازهای اپلیکیشن ما را برآورده کند؛ ما برای هر کار از مناسب ترین ابزار استفاده می کنیم و در اپلیکیشنی با قابلیت های متنوع، این به معنای استفاده از ابزارهای مختلف است.»
مراحل انتخاب دیتابیس مناسب اپلیکیشن
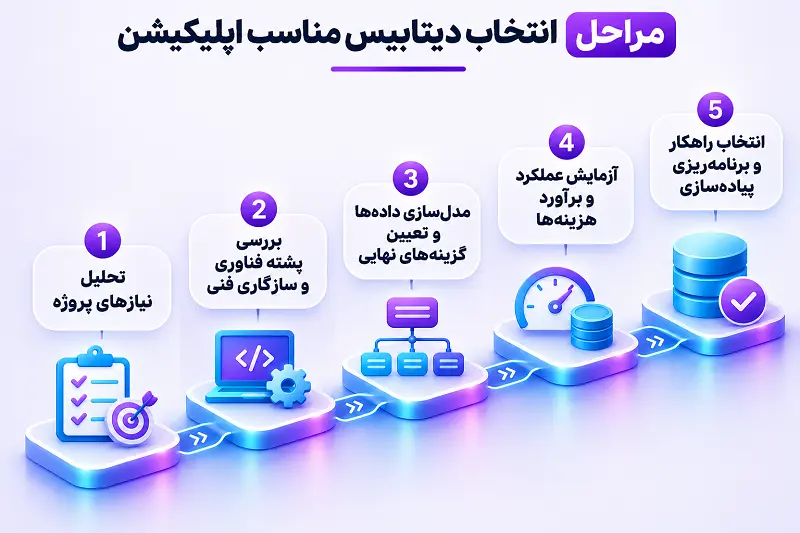
برای انتخاب دیتابیس مناسب اپلیکیشن، باید نیازهای پروژه را بررسی کرد و گزینه های موجود را بر اساس شرایط فنی و اجرایی سنجید. مراحل اصلی این فرایند عبارتند از:
۱. تحلیل نیازهای پروژه
در نخستین مرحله، نیازهای اصلی اپلیکیشن و انتظارات تیم توسعه و سایر ذی نفعان پروژه مشخص می شوند. قابلیت های اپلیکیشن، نوع اطلاعات موردنیاز، عملیات اصلی روی داده ها و ارتباط با سایر سامانه ها از جمله موارد مهم این بررسی هستند. برای مثال، در یک اپلیکیشن فروشگاهی، ثبت سفارش، مدیریت موجودی و پردازش پرداخت باید در طراحی راهکار ذخیره سازی داده ها در نظر گرفته شوند. خروجی این مرحله، فهرستی از نیازهای ضروری برای ارزیابی گزینه های دیتابیس است.
۲. بررسی پشته فناوری (Tech Stack) و سازگاری فنی
پس از مشخص شدن نیازهای پروژه، سازگاری دیتابیس های موردنظر با فناوری ها و زیرساخت موجود بررسی می شود. زبان برنامه نویسی، فریم ورک بک اند، ابزارهای اتصال، محیط استقرار و سرویس های مرتبط با اپلیکیشن در این ارزیابی اهمیت دارند. همچنین، در صورت اتصال اپلیکیشن به سامانه ای موجود، امکان تبادل اطلاعات و سازگاری فنی میان دو سیستم باید بررسی شود. این مرحله به شناسایی محدودیت های اجرایی و انتخاب گزینه های سازگار با معماری پروژه کمک می کند.
۳. مدل سازی داده ها و تعیین گزینه های نهایی
در این مرحله، ساختار اطلاعات و ارتباط میان داده ها مشخص می شود تا تناسب گزینه های مختلف با نیازهای اپلیکیشن بهتر ارزیابی شود. نمودار رابطه موجودیت ها (ERD) برای نمایش موجودیت ها و ارتباط میان آن ها و نمودار جریان داده (DFD) برای نمایش جریان اطلاعات در سیستم کاربرد دارند. این مدل سازی به درک بهتر ساختار داده ها و نحوه استفاده از آن ها کمک می کند و در کنار سایر نیازهای فنی پروژه، مبنایی برای انتخاب گزینه های مناسب تر جهت آزمایش و مقایسه فراهم می سازد.
۴. آزمایش عملکرد و برآورد هزینه ها
پس از انتخاب گزینه های اولیه، عملکرد آن ها در سناریوهایی نزدیک به شرایط واقعی اپلیکیشن بررسی می شود. اجرای کوئری های پرتکرار، ثبت هم زمان اطلاعات، بازیابی داده ها و پردازش درخواست ها از جمله موارد قابل آزمایش هستند. بهتر است ارزیابی با حجم داده و الگوی استفاده مورد انتظار پروژه انجام شود؛ زیرا نتایج آزمایش به عواملی مانند سخت افزار، تنظیمات دیتابیس و نوع بار کاری نیز وابسته اند.
هم زمان، هزینه های زیرساخت یا سرویس ابری، ذخیره سازی، پشتیبان گیری، پایش و نگهداری هر گزینه برآورد می شوند. بررسی عملکرد و هزینه ها کمک می کند گزینه ها بر اساس شرایط واقعی پروژه مقایسه شوند.
۵. انتخاب راهکار و برنامه ریزی پیاده سازی
در آخرین مرحله، نتایج آزمایش ها و برآورد هزینه ها با نیازهای ضروری پروژه مقایسه می شوند تا دیتابیس مناسب انتخاب شود. سازگاری با معماری اپلیکیشن، پاسخ گویی به نیازهای فعلی و امکان توسعه در آینده از معیارهای مهم این تصمیم گیری هستند. پس از انتخاب، برنامه پیاده سازی شامل زمان بندی، مسئولیت اعضای تیم، آماده سازی زیرساخت، انتقال داده های موجود و آزمایش صحت عملکرد سیستم مشخص می شود.
اگر پروژه به مهاجرت از دیتابیس دیگری نیاز داشته باشد، روش انتقال و حفظ یکپارچگی داده ها نیز باید از قبل برنامه ریزی شود. در نهایت، انتخاب دیتابیس زمانی به نتیجه مطلوب می رسد که با نیازهای کسب وکار، محدودیت های اجرایی و برنامه توسعه اپلیکیشن هماهنگ باشد.
نتیجه گیری؛ راهنمای انتخاب دیتابیس مناسب اپلیکیشن
انتخاب دیتابیس مناسب اپلیکیشن تصمیمی استراتژیک در معماری نرم افزار است که بر عملکرد، امنیت، توسعه پذیری و هزینه های نگهداری محصول تأثیر می گذارد. PostgreSQL،MySQL وMongoDB هرکدام قابلیت ها و محدودیت های خاص خود را دارند و انتخاب میان آن ها باید بر اساس ساختار داده ها، نوع تراکنش ها، الگوی استفاده و چشم انداز رشد محصول انجام شود. بررسی این عوامل در مراحل اولیه طراحی، به انتخاب زیرساختی متناسب با نیازهای پروژه و کاهش هزینه های احتمالی تغییر معماری در آینده کمک می کند.
توسعه اپلیکیشن اختصاصی با کیان تجارت شریف
کیان تجارت شریف با بهره گیری از تخصص های معماری نرم افزار، توسعه فول استک، طراحی تجربه کاربری (UI/UX) و تضمین کیفیت (QA)، اپلیکیشن ها و سامانه های اختصاصی را متناسب با نیازهای هر کسب وکار طراحی و پیاده سازی می کند. تجربه اجرای پروژه هایی در حوزه تجارت الکترونیک، خدمات، املاک، آموزش و حمل ونقل، امکان طراحی راهکارهای متناسب با نیازهای عملیاتی، حجم داده ها و تعداد کاربران هر محصول را فراهم می کند. در این فرایند، انتخاب دیتابیس و طراحی معماری فنی نیز بر اساس الزامات پروژه و برنامه توسعه آن انجام می شود.
برای راه اندازی یا بازطراحی اپلیکیشن کسب وکار خود، می توانید جهت بررسی نیازمندی ها، ارزیابی فنی و مشاوره معماری نرم افزار با متخصصان کیان تجارت در ارتباط باشید.
سوالات متداول


پرسش و پاسخ
پرسش مورد نظر خود را مطرح نمایید
 مشاوره طراحی اپ
مشاوره طراحی وب اپ
مشاوره طراحی سایت
مشاوره سئوی سایت
مشاوره تبلیغات گوگل
مشاوره اینستاگرام
اشتراک گذاری این مطلب

